2015年2月26日木曜日

正則化項について


はじめに


 これまでいくつかのNeural Networkを考察してきた( 1次元ロジスティック回帰、 多次元ロジスティック回帰、 多層パーセプトロン、 Convolutional Neural Network)。 どの場合もパラメータを求める際はNegative Log Likelihood(NLL)を最小化した。過学習を防ぐため、正則化項(regularization term)と呼ばれる項をNLLに追加することがある。ここでは、この正則化項の役割についてまとめる。

正則化項


 多次元ロジスティック回帰を例として考える。全観測値の実現確率は次式で与えられた。 \begin{equation} P(W,\vec{b})=\prod_{n=1}^{N}\;p(c^{n}\;|\;\vec{x}^{\;n}\;;\;W,\vec{b}) \end{equation} ここで、$\vec{x}^{\;n}$ は観測値、$c^{n}$ はラベル、$W,\vec{b}$ はモデルを調節するパラメータである。上式におけるパラメータは確率変数とは無関係な量として定義したが、これも確率変数とみなし以下のように事前確率 $p(W,\vec{b})$ を導入することができる。 \begin{equation} P(W,\vec{b})=\prod_{n=1}^{N}\;p(c^{n}\;|\;\vec{x}^{\;n}\;;\;W,\vec{b})\;p(W,\vec{b}) \end{equation} すなわち、パラメータが確率 $p(W,\vec{b})$ で与えられたときの観測値の実現確率を考えるのである。 両辺の対数をとりマイナスを付ける。 \begin{eqnarray} L(W,\vec{b})&=&-\ln{P(W,\vec{b})}\nonumber \\ &=&-\sum_{n=1}^{N}\;\ln{p(c^{n}\;|\;\vec{x}^{\;n}\;;\;W,\vec{b})}-\ln{p(W,\vec{b})} \label{nll} \end{eqnarray} これまで考えてきたNLLに $-\ln{p(W,\vec{b})}$ が付加されることが分る。これが正則化項である。 $p(W,\vec{b})$ として以下の形の正規分布を考えることが多い。 \begin{equation} p(W,\vec{b}) = \exp{\left(-\eta \sum_{i,j}\;|w_{i,j}|^2\right)} \end{equation} ここで、$w_{i,j}$ は $W$ の成分、$\eta$ は正の量である。このとき $L(W,\vec{b})$ は以下のようになる。 \begin{equation} L(W,\vec{b})=-\sum_{n=1}^{N}\;\ln{p(c^{n}\;|\;\vec{x}^{\;n}\;;\;W,\vec{b})}+\eta \sum_{i,j}\;|w_{i,j}|^2 \end{equation} 上式を最小化する過程で、右辺第2項は $w_{i,j}$ を小さくする力となる。すなわち、正則化項はNeural Networkのユニット間の結びつきを 弱めるものであり、これが過学習を抑制するのである。上記のように $|w_{i,j}|$ の2乗のものを $L_2$ 正則化項、1乗のものを $L_1$ 正則化項と呼ぶ。

2015年2月9日月曜日

Convolutional Neural Network


はじめに


 先のページでは多層パーセプトロンを解説した。今回は、これを拡張することによりConvolutional Neural Networkを導く。

多層パーセプトロン


 隠れ層が一層の多層パーセプトロンは以下のような構造であった。
これに対応する式は以下のように与えられる。 \begin{eqnarray} y_k &=& \pi\left(\;f_k\left( \vec{z}; W^{(2)},\vec{b}^{\;(2)}\right)\;\right) \label{eprob-2}\\ \pi(a_k) &=& \frac{\exp{(a_k)}} {\sum_{j=1}^{K}\;\exp{(a_j)}} \label{softmax-1}\\ \vec{f}\left( \vec{z}; W^{(2)},\vec{b}^{\;(2)}\right) &=& W^{(2)\;T}\;\vec{z} + \vec{b}^{\;(2)}\label{projection-2} \end{eqnarray} \begin{eqnarray} z_h &=& \tanh\left(\;g_h\left( \vec{x}; W^{(1)},\vec{b}^{\;(1)}\right)\;\right) \label{eprob-1}\\ \vec{g}\left( \vec{x}; W^{(1)},\vec{b}^{\;(1)}\right) &=& W^{(1)\;T}\;\vec{x} + \vec{b}^{\;(1)}\label{projection-1} \end{eqnarray} ここで、$W^{(1)}$ は $D\times H$ 行列、$\vec{b}^{\;(1)}$ は $H$ 次元ベクトル、$W^{(2)}$ は $H\times K$ 行列、$\vec{b}^{\;(2)}$ は $K$ 次元ベクトルである。ただし、隠れ層の活性化関数として $\tanh{}$ を採用している。 最下層は入力層であり $D$ 個のユニットから構成される。隠れ層のユニット数は $H$ 個、最上層は出力層であり $K$ 個のユニットから構成される。これを適用する具体例として、$D$ 次元のベクトルとして与えられる観測値を $K$ 個のクラスのいずれかに分類する多分類問題を挙げることができる。
 上図における層間の接続に注目したものが下図である。各ユニットは、下層の全ユニットと接続している。

Convolutional Neural Network(CNN)


 いま、入力層(input layer)と隠れ層(hidden layer)の間に複数の層を挿入する。
上図は、convolution layerと pooling layerの対を2つ挿入したものである。 一般に、この対を任意の数だけ挿入したものをconvolutional neural networkと呼ぶ。以下各層について説明する。

① convolution layer

 多次元ロジスティック回帰や多層パーセプトロンでは、1次元のベクトルを入力値としてきたが、ここでは入力値として2次元ベクトルを考える。具体的には画像が入力値となる場合を考察する。まず最初に、$m$ 番目の入力画像の $l$ 番目のチャンネルを考え、位置 $(i,j)$ にある画素 $x_{m,l,i,j}$ について以下の計算を行なう。 \begin{equation} g_{m,k,i,j} = \sum_{p,q,l} \; w_{k,l,p,q}\;x_{m,l,i+p,j+q} \label{eq1} \end{equation} これは、矩形のフィルタ $w_{k,l}$ を使って convolution を行い、$l$ について和をとることと等価である。カラー画像なら $l$ の総数は3、グレースケールなら1である。convolution を $\circledast$ で表すことにすれば、式(\ref{eq1})は \begin{equation} g_{m,k} = \sum_{l} \; w_{k,l} \circledast x_{m,l} \label{eq2} \end{equation} と書くことができる。

② max pooling

 次に行なう処理は pooling である。pooling の方法にはいくつかあるが、ここでは max pooling を取り上げる。max pooling とは、 画像を $a\times a$ の領域に細分し、各領域内の最大値でその領域を代表させる処理である。$a=2$ なら $w\times h$の画像は$w/2\times h/2$ のサイズにダウンサンプリングされる。いま形式的に max pooling の処理を $p_{\rm{pooling}}(\cdot)$ と書くことにすれば、この処理の出力値は \begin{equation} q_{m,k} = p_{\rm{pooling}}\left(\sum_{l} \; w_{k,l} \circledast x_{m,l}\right) \label{eq3} \end{equation} となる。

③ 活性化関数

 ここまでの出力値 $q_{m,k}$ にスカラー量であるバイアス項 $b_{k}$ を加え、$\tanh$ で活性化する。 \begin{equation} r_{m,k} = \tanh{(q_{m,k}+b_k)} \label{eq4} \end{equation} 出力値 $r_{m,k}$ は、feature mapと呼ばれる。これを新たな入力値 $x_{m,l}$ とみなして ①②③ の処理を繰り返す。その際、フィルタの数 $k$ を変えることができる。たとえば、最初の処理①②③では20種類のフィルタを使い、次の処理①②③では50種類のフィルタを使うなどである。

 convolution layerとpooling layerの対が2つ、最初の画像サイズが28$\times$28、フィルタサイズが5$\times$5の場合を考える。最初のconvolution layerにより画像サイズは 24$\times$ 24となり、それに引き続く pooling layer により画像サイズは12$\times$12となる。次のconvolution layerへの入力画像のサイズは12$\times$ 12となり、フィルタサイズが最初と同じなら、convolution layerにより画像サイズは8$\times$8、pooling layerにより画像サイズは4$\times$4となる。2つ目のcovolution に使うフィルタの数が50なら、4$\times$4の画像が50個出来上がる。すなわち、1枚の画像(サイズは28$\times$28)から50組の16(=$4\times 4$)画素が作成される。この画素を一列に並べた800($=50\times 16$)次元のベクトルを多層パーセプトロンのhidden layerの入力とみなす。あとの処理は先のページと同じである。

計算を行なう際の留意点

  • CNNの計算量はMLPと比べ著しく多くなる。 私のiMac(3.06GHz Intel Core 2 Duo, 4GB)で、参考文献にあるtheanoコードを実行したところ、MLPで8.32時間、CNNで20.99時間となった。0-1lossの値は、MLPで1.68%、CNNで0.91%であった。
  • 各層の計算時間を同じにするため、(feature mapの数$\times$feature mapを構成する画素の数)を各層でほぼ同じにすることがよく行なわれる。
  • 考察するデータセットごとに最適なフィルタサイズは変わる。入力画像が28$\times$28程度であれば5$\times$5のフィルタがよく使われる。一方、数百画素$\times$数百画素の画像に対しては12$\times$12や15$\times$15程度のフィルタを用いることが多い。
  • max poolingを行なわない選択肢もある。行なうとしても、そのサイズは2$\times$2が限度である。これ以上のdownsamplingを行なうと、多くの情報が失われてしまう。
  • whitening(白色化)を導入することにより識別率は高くなる。
  • 確率的勾配降下法の各イテレーションごとに学習率を小さくすることにより収束速度を上げることができる。

まとめ


 多次元ロジスティック回帰は入力層と出力層の2層からなるNeural Network、多層パーセプトロンはこの2層の間に隠れ層を複数個挿入したNeural Network、そして、Convolutional Neural Networkは、多層パーセプトロンにconvolution層とpooling層の対を複数個挿入したNeural Networkである。多分類問題に適用した際の識別率は、一般的には、入力層と出力層の間の中間層が増える程高くなる。
 

参考文献


Convolutional Neural Networks (LeNet)
Theanoを使った実装が掲載されている。

2015年1月25日日曜日

多層パーセプトロン


はじめに


 先のページでは多次元ロジスティック回帰について考察した。ここでは、これを拡張することにより、多層パーセプトロンを導入する。

多次元ロジスティック回帰


 先のページでは、観測値として $D$ 次元のベクトル $\vec{x}$ を考え、これが $K$ 個のクラスのいずれかに属する多分類問題を考えた。式を書き下ろすと、 \begin{eqnarray} y_k &=& \pi\left(\;f_k\left( \vec{x}; W,\vec{b}\right)\;\right) \label{eprob}\\ \pi(a_k) &=& \frac{\exp{(a_k)}} {\sum_{j=1}^{K}\;\exp{(a_j)}} \label{softmax}\\ \vec{f}\left( \vec{x}; W,\vec{b}\right) &=& W^{T}\;\vec{x} + \vec{b}\label{projection} \end{eqnarray} となる。ただし、$(W,\vec{b})$ はモデルを記述するパラメータであり、前者は $D\times K$ 行列、後者は $K$ 次元ベクトルである。 これを図で示したものが下図である。
この図から、多次元ロジスティック回帰は入力層と出力層の2層からなるNeural Networkであることが分る。

多層パーセプトロン


 上記の構造に、中間層(隠れ層と呼ぶ)を挿入する。
これに対応する式は以下のように与えられる。 \begin{eqnarray} y_k &=& \pi\left(\;f_k\left( \vec{z}; W^{(2)},\vec{b}^{\;(2)}\right)\;\right) \label{eprob-2}\\ \pi(a_k) &=& \frac{\exp{(a_k)}} {\sum_{j=1}^{K}\;\exp{(a_j)}} \label{softmax-1}\\ \vec{f}\left( \vec{z}; W^{(2)},\vec{b}^{\;(2)}\right) &=& W^{(2)\;T}\;\vec{z} + \vec{b}^{\;(2)}\label{projection-2} \end{eqnarray} \begin{eqnarray} z_h &=& \tanh\left(\;g_h\left( \vec{x}; W^{(1)},\vec{b}^{\;(1)}\right)\;\right) \label{eprob-1}\\ \vec{g}\left( \vec{x}; W^{(1)},\vec{b}^{\;(1)}\right) &=& W^{(1)\;T}\;\vec{x} + \vec{b}^{\;(1)}\label{projection-1} \end{eqnarray} ここで、$W^{(1)}$ は $D\times H$ 行列、$\vec{b}^{\;(1)}$ は $H$ 次元ベクトル、$W^{(2)}$ は $H\times K$ 行列、$\vec{b}^{\;(2)}$ は $K$ 次元ベクトルである。隠れ層の活性化関数として、$\tanh{}$ を採用したが、他にsigmoid関数を考えることもできる。一般に、隠れ層の数を任意にした構造を多層パーセプトロンと呼ぶ。多次元ロジスティック回帰の場合と同様に、確率的勾配降下法を用いて解くことができ、多次元ロジスティック回帰よりも精度の良い識別率を実現できる。

計算を行なう際の留意点


  • 勾配降下法では、大域的最小値を求めることはできない。
  • 活性化関数としてよく用いられる関数は、$\tanh$とsigmoidの2つである。原点について対称な関数が好まれる理由は、次の層への入力値の平均値を0に近い値にできるからである。経験的にsigmoidよりも$\tanh$の方が収束性が良い。
  • 行列$W$の初期値は、0近傍の十分小さな値とする。0近傍であれば、活性化関数の線形部分が適用されるので、勾配を大きくすることができる。
  • 活性化関数を$\tanh$とするときは$[-\frac{\sqrt{6}}{\sqrt{N_{\rm in}+N_{\rm out}}}, \frac{\sqrt{6}}{\sqrt{N_{\rm in}+N_{\rm out}}}]$の範囲で、sigmoidを活性化関数とするときは$[-4\frac{\sqrt{6}}{\sqrt{N_{\rm in}+N_{\rm out}}}, 4\frac{\sqrt{6}}{\sqrt{N_{\rm in}+N_{\rm out}}}]$の範囲で一様乱数を発生させ、$W$を初期化すればよい。ここで、$N_{\rm in}$は入力層にあるユニットの数、$N_{\rm out}$は隠れ層にあるユニットの数である。

参考文献


Multilayer Perceptron
Theanoを使った実装が掲載されている。

2015年1月14日水曜日

多次元ロジスティック回帰(Softmax 回帰)


はじめに


 先のページでは1次元ロジスティック回帰について考察した。ここでは、多次元ロジスティック回帰を取り上げる。

多次元ロジスティック回帰


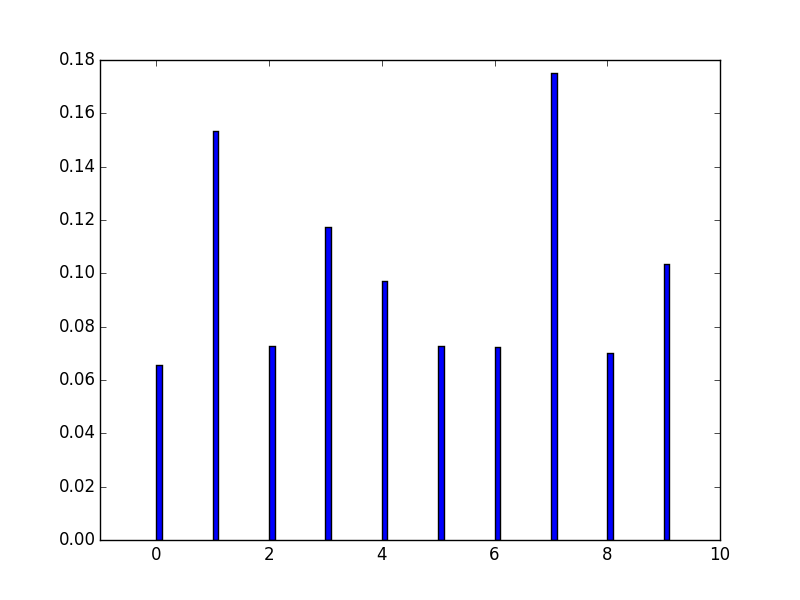
 多分類問題を考える。$N$ 個の $D$ 次元ベクトル $\vec{x}^{\;n},n=1,\cdots,N$ が与えられ、それぞれが ${1,\cdots,K}$ のいずれかのラベルを持つとする。このとき、観測値が従う確率分布モデル $p(c=1,\cdots,K\;|\;\vec{x}\;;\;W,\vec{b})$ を求めたい。ここで、$W,\vec{b}$ はモデルを調節するパラメータである。$W$ は $D \times K$ 行列、$\vec{b}$ は $K$ 次元ベクトルである。各観測値が他の観測値の影響を受けないと仮定すれば、全ての観測値の確率は次式で与えられる。 \begin{equation} L(W,\vec{b})=\prod_{n=1}^{N}\;p(c^{n}\;|\;\vec{x}^{\;n}\;;\;W,\vec{b}) \label{likelihood} \end{equation} これが最大となるように $(W,\vec{b})$ を調節すればよい。計算を容易にするため次式の最小化を考える。 \begin{equation} L(W,\vec{b})=-\sum_{n=1}^{N}\;\ln{p(c^{n}\;|\;\vec{x}^{\;n}\;;\;W,\vec{b})} \label{nll} \end{equation} 上式を負の対数尤度(Negative Log Likelihood:NLL)関数と呼ぶ。確率 $p$ は次式で定義される。 \begin{equation} p(c\;|\;\vec{x}\;;\;W,\vec{b})=\prod_{k=1}^{K}\;(y_k)^{t_k} \label{prob} \end{equation} ここで、$y_k$ は $K$ 次元ベクトル $\vec{y}$ の $k$ 番目の成分、$t_k$ は $K$ 次元ベクトル $\vec{t}$ の $k$ 番目の成分である。$y_k$ は次式で定義される。 \begin{eqnarray} y_k &=& \pi\left(\;f_k\left( \vec{x}; W,\vec{b}\right)\;\right) \label{eprob}\\ \pi(a_k) &=& \frac{\exp{(a_k)}} {\sum_{j=1}^{K}\;\exp{(a_j)}} \label{softmax}\\ \vec{f}\left( \vec{x}; W,\vec{b}\right) &=& W^{T}\;\vec{x} + \vec{b}\label{projection} \end{eqnarray} 行列やベクトルの肩にある $T$ は転置を表す。$\vec{f}$ は $K$ 次元ベクトルであり、$f_k$ はその $k$ 番目の成分を表す。 $\vec{t}$ は、観測値 $\vec{x}$ が持つラベルに相当する成分を1、それ以外の成分を0とする $K$ 次元ベクトルである。 たとえば、ラベル $3$ を持つなら \begin{equation} \vec{t} = (0,0,1,0,\cdots,0)^T \end{equation} となる。式(\ref{softmax})をsoftmax関数と呼ぶ。 $a_k={0,\cdots,9}$としたときのsoftmax関数を下に示す。
次式が成り立つことに注意する。 \begin{equation} \sum_{k=1}^{K}\;\pi(a_k)=1 \end{equation} すなわち、 \begin{equation} \sum_{k=1}^{K}\;y_k=1 \end{equation} ということであり、観測値 $\vec{x}$ はいずれかのラベルに必ず属するということである。 式(\ref{nll})に式(\ref{prob})を代入すると次式を得る。 \begin{equation} L(W,\vec{b})=-\sum_{n=1}^{N}\;\sum_{k=1}^{K} t_k^n\;\ln{(y_k^n)} \end{equation} ここまでの議論をまとめる。
  1. 式(\ref{projection})を使って、$D$次元ベクトル(観測値)を $K$ 次元ベクトルに射影する。
  2. $K$ 次元ベクトルの各成分を使って確率(\ref{softmax})を導入する。
  3. 確率的勾配降下法を用いて対数尤度を最小化し、最適なモデルを決定する。
計算を容易にするため、 $x^n_d,y^n_k,t^n_k$ を $x_{dn},y_{kn},t_{kn}$ に置き換え、これを行列の成分とみなすことにする。 \begin{equation} L(W,\vec{b})=-\sum_{n=1}^{N}\;\sum_{k=1}^{K} t_{kn}\;\ln{(y_{kn})} \label{nllspecial} \end{equation}

更新式


確率的勾配降下法については先のページで説明したので、ここでは更新式だけを示す。
 式(\ref{nllspecial})を $W$ の成分 $w_{dk}$ で微分する。 \begin{eqnarray} \frac{\partial L}{\partial w_{dk}} &=& -\sum_{n=1}^{N}\;\sum_{s=1}^{K}\;t_{sn}\frac{1}{y_{sn}}\frac{\partial y_{sn}}{\partial a_{sn}}\frac{\partial a_{sn}}{\partial w_{dk}} \end{eqnarray} ここで、 \begin{eqnarray} \frac{\partial y_{sn}}{\partial a_{sn}}&=&y_{sn}(1-y_{sn}) \\ \frac{\partial a_{sn}}{\partial w_{dk}}&=&x_{dn}\;\delta_{ks} \end{eqnarray} が成り立つので、これらを代入すると、 \begin{eqnarray} \frac{\partial L}{\partial w_{dk}} &=& \sum_{n=1}^{N}\;t_{kn}(y_{kn}-1)\;x_{dn} \\ &=& \sum_{n=1}^{N}\;(y_{kn}-t_{kn})\;x_{dn} \end{eqnarray} を得る。ただし、$t_{kn}\;y_{kn}=y_{kn}$ を用いた。同様に $b_k$ で微分すると次式を得る。 \begin{equation} \frac{\partial L}{\partial b_{k}} = \sum_{n=1}^{N}\;(y_{kn}-t_{kn}) \end{equation} いま、$e_{kn}=y_{kn}-t_{kn}$ と置くと \begin{eqnarray} \frac{\partial L}{\partial w_{dk}} &=& \sum_{n=1}^{N}\; x_{dn}\;e_{kn}\; \\ &=& \left(X\;E^T\right)_{dk} \label{update1}\\ \frac{\partial L}{\partial b_{k}} &=& \sum_{n=1}^{N}\;e_{kn} \label{update2} \end{eqnarray} となる。ここで $E$ は $e_{kn}$ を成分とする行列、$X$ は $x_{dn}$ を成分とする行列である。これらより更新式は以下のようになる。 \begin{eqnarray} w_{dk} &\leftarrow& w_{dk} - \eta \; \left(X\;E^T\right)_{dk} \\ b_{k} &\leftarrow& b_{k} - \eta \; \sum_{n=1}^{N}\;e_{kn} \end{eqnarray} この更新式を使って、確率的勾配降下法を実行する。以下に各行列を書き下ろしておく。 \begin{eqnarray} Y &=& \left(\begin{array}{cccc} y_{11} & y_{12} & \cdots & y_{1N} \\ y_{21} & y_{22} & \cdots & y_{2N} \\ \vdots & \vdots & \ddots & \vdots \\ y_{K1} & y_{K2} & \cdots & y_{KN} \end{array} \right) = {\bf \pi}(W^T\;X+B)\label{pi}\\ \nonumber\\[3pt] W &=& \left(\begin{array}{cccc} w_{11} & w_{12} & \cdots & w_{1K} \\ w_{21} & w_{22} & \cdots & w_{2K} \\ \vdots & \vdots & \ddots & \vdots \\ w_{D1} & w_{D2} & \cdots & w_{DK} \end{array} \right)\\ \nonumber\\[3pt] X &=& \left(\begin{array}{cccc} x_{11} & x_{12} & \cdots & x_{1N} \\ x_{21} & x_{22} & \cdots & x_{2N} \\ \vdots & \vdots & \ddots & \vdots \\ x_{D1} & x_{D2} & \cdots & x_{DN} \end{array} \right)\\ \nonumber\\[3pt] B &=& \left(\begin{array}{cccc} b_{1} & b_{1} & \cdots & b_{1} \\ b_{2} & b_{2} & \cdots & b_{2} \\ \vdots & \vdots & \ddots & \vdots \\ b_{K} & b_{K} & \cdots & b_{K} \end{array} \right) \\ \nonumber\\[3pt] T &=& \left(\begin{array}{cccc} t_{11} & t_{12} & \cdots & t_{1N} \\ t_{21} & t_{22} & \cdots & t_{2N} \\ \vdots & \vdots & \ddots & \vdots \\ t_{K1} & t_{K2} & \cdots & t_{KN} \end{array} \right) \\[3pt] E &=& Y-T \end{eqnarray} $B$ は同じ列から構成される $K\times N$ 行列である。 式(\ref{pi})の関数 $\pi$ は先に定義したsoftmax関数であり、行列の各成分に作用させることとする。

実装


pythonを使って実装を行なった。 $K=3$、$D=2$、$N=1500$とした。 すなわち、2次元平面上の3分類問題である。1500個の点を3等分し、各集合に1,2,3のラベルを割り振った。
  1. 8-9行目:式(\ref{softmax})である。
  2. 12-13行目:式(\ref{eprob})である。
  3. 16-21行目:式(\ref{update1}),(\ref{update2})である。
  4. 24-28行目:誤差を描画する関数である。
  5. 30-45行目:境界線を描画する関数である。
  6. 47-57行目:観測値を作る関数である。
  7. 59-64行目:ラベルを作る関数だる。
  8. 67-104行目:確率的勾配降下法を実行するコードである。
下図は、次式で定義される3つの量を、横軸に試行回数をとり、プロットしたものである。 \begin{eqnarray} \bar{e}_1&=&\frac{1}{\left|\Lambda\right|}\sum_{n\in\Lambda}\;e_{1n}\;\;(\mbox{赤線})\\ \bar{e}_2&=&\frac{1}{\left|\Lambda\right|}\sum_{n\in\Lambda}\;e_{2n}\;\;(\mbox{緑線})\\ \bar{e}_3&=&\frac{1}{\left|\Lambda\right|}\sum_{n\in\Lambda}\;e_{3n}\;\;(\mbox{青線})\\ \end{eqnarray} ここで、$\Lambda$ はミニバッチを表し、$|\Lambda|$ はそこに含まれる点の数を表す。
$K=3$の場合、$(W,\vec{b})$ は以下のようになる。 \begin{eqnarray} W &=& \left(\begin{array}{ccc} w_{11} & w_{12} & w_{13} \\ w_{21} & w_{22} & w_{23} \end{array} \right)\\ \nonumber\\[3pt] \vec{b} &=& \left(\begin{array}{c} b_{1} \\ b_{2} \\ b_{3} \end{array} \right) \end{eqnarray} また、計算される $\vec{f}$ は次式のようになる。 \begin{eqnarray} \vec{f} &=& \left(\begin{array}{c} f_{1} \\ f_{2} \\ f_{3} \end{array} \right) \\ f_1 &=& \vec{w}^{\;T}_1\cdot\vec{x}+\vec{b}_1 \\ f_2 &=& \vec{w}^{\;T}_2\cdot\vec{x}+\vec{b}_2 \\ f_3 &=& \vec{w}^{\;T}_3\cdot\vec{x}+\vec{b}_3 \\ \vec{w}_1 &=& \left(\begin{array}{c} w_{11} \\ w_{21} \end{array} \right) \\ \vec{w}_2 &=& \left(\begin{array}{c} w_{12} \\ w_{22} \end{array} \right) \\ \vec{w}_3 &=& \left(\begin{array}{c} w_{13} \\ w_{23} \end{array} \right) \end{eqnarray} いま、各点集合の境界線を考える。 たとえば、ラベル1を持つ点集合とラベル2を持つ点集合の境界線上では、ラベル1を持つ確率 $p_1$ とラベル2を持つ確率 $p_2$ が等しいはずである。 式(\ref{eprob})より \begin{eqnarray} p_1 &=& \frac{\exp{(f_1)}}{\exp{(f_1)}+\exp{(f_2)}+\exp{(f_3)}} \\ p_2 &=& \frac{\exp{(f_2)}}{\exp{(f_1)}+\exp{(f_2)}+\exp{(f_3)}} \\ \end{eqnarray} であるから、境界線上では、$f_1=f_2$ が成り立つことになる。 従って、この2つの点集合を分ける境界線は次式で記述される。 \begin{equation} (\vec{w}^{\;T}_1- \vec{w}^{\;T}_2)\cdot\vec{x}+(\vec{b}_1-\vec{b}_2)=0 \end{equation} 同様にラベル2と3を分ける境界線は \begin{equation} (\vec{w}^{\;T}_2- \vec{w}^{\;T}_3)\cdot\vec{x}+(\vec{b}_2-\vec{b}_3)=0 \end{equation} ラベル1と3を分ける境界線は \begin{equation} (\vec{w}^{\;T}_1- \vec{w}^{\;T}_3)\cdot\vec{x}+(\vec{b}_1-\vec{b}_3)=0 \end{equation} である。 これらを図示したものが下図である。ラベル1を持つ点を赤、ラベル2を持つ点を緑、ラベル3を持つ点を青で表している。 青線がラベル1と2の境界線、緑線がラベル2と3の境界線、赤線がラベル1と3の境界線である。
多次元ロジスティック回帰におけるNLLの最小化はconvex optimizationとなるので、初期値に関わらず大域的最小値に収束する。

2014年12月29日月曜日

pcl-1.7.2をmacでコンパイル

前回、pcl-1.7.1をコンパイルしたときは、 いろいろエラーが出ましたが、pcl-1.7.2は何の問題もなくコンパイルできました。

ここからソースをダウンロードして、解凍。 依存ライブラリは既にmacportsでインストールされている。

2014年11月24日月曜日

1次元ロジスティック回帰と確率的勾配降下法


はじめに


 ここでは、1次元ロジスティック回帰と、これを解く際に用いられる確率的勾配降下法についてまとめる。

1次元ロジスティック回帰


 2分類問題を考える。$N$ 個の観測値 $\vec{x}^{\;i},i=1,\cdots,N$ が与えられ、それぞれ0か1のラベルを持つとする。このとき、観測値が従う確率分布モデル $p(c=0,1\;|\;\vec{x}\;;\;\vec{\omega},b)$ を求めたい。ここで、$\vec{\omega},b$ はモデルを調節するパラメータである。各観測値が他の観測値の影響を受けないと仮定すれば、全ての観測値の確率は 次式で与えられる。 \begin{equation} L(\vec{\omega},b)=\prod_{i=1}^{N}\;p(c^{i}\;|\;\vec{x}^{\;i}\;;\;\vec{\omega},b) \label{likelihood} \end{equation} これが最大となるように $(\vec{\omega},b)$ を調節すればよい。計算を容易にするため次式の最小化を考える。 \begin{equation} L(\vec{\omega},b)=-\sum_{i=1}^{N}\;\ln{p(c^{i}\;|\;\vec{x}^{\;i}\;;\;\vec{\omega},b)} \label{nll} \end{equation} 上式を負の対数尤度(Negative Log Likelihood:NLL)関数と呼ぶ。ところで、観測値のラベル $c$ を0か1に制限したので、確率 $p$ は以下のように書くことができる。 \begin{equation} p(c\;|\;\vec{x}\;;\;\vec{\omega},b)=s(1\;|\;\vec{x}\;;\;\vec{\omega},b)^c\;\left\{1-s(1\;|\;\vec{x}\;;\;\vec{\omega},b)\right\}^{1-c} \end{equation} ここで、$s$ は $c=1$ となる確率である。$s$ と $\vec{x}$ を結びつけるモデルが必要である。1次元ロジスティック回帰では次のモデルを考える。 \begin{eqnarray} s(1\;|\;\vec{x}\;;\;\vec{\omega},b) &=& \sigma\left(f(\vec{x}\;;\;\vec{\omega},b)\right)\nonumber \\ \sigma(a) &=& \frac{1}{1+\exp{(-a)}}\label{sigmoid}\\ f(\vec{x}\;;\;\vec{\omega},b) &=& \vec{\omega}^{\;T}\cdot\vec{x}+b \label{projection} \end{eqnarray} 関数 $\sigma$ はシグモイド関数と呼ばれ、以下のような形をしている。
ベクトル $\vec{x}$ を式(\ref{projection})により1次元に射影し、その結果を式(\ref{sigmoid})を使って区間(0,1)に射影し、これを確率とみなすわけである。式(\ref{nll})をパラメータ $(\vec{\omega},b)$ で微分するのであるが、その前に少しだけ式を一般化する。いま、$\vec{x}$ に1次元加えたベクトルを導入する。 \begin{equation} \vec{X}=(\vec{x},1) \end{equation} 最後の次元の値は常に1である。さらに、$\vec{\Omega}$ を次式で定義する。 \begin{equation} \vec{\Omega}=(\vec{\omega},b) \end{equation} このとき関数 $f$ は \begin{equation} f(\vec{X}\;;\;\vec{\Omega}) = \vec{\Omega}^{\;T}\cdot\vec{X} \label{new_projection} \end{equation} と書くことができる。この表式を使うと $L$ は \begin{equation} L(\vec{\Omega})=-\sum_{i=1}^{N} \left\{ c^{i}\ln{s(1\;|\;\vec{X}^{\;i}\;;\;\vec{\Omega})} + (1-c^{i}) \ln{ \left( 1-s(1\;|\;\vec{X}^{\;i}\;;\;\vec{\Omega}) \right) } \right\} \end{equation} となる。ただし、 \begin{eqnarray} s(1\;|\;\vec{X}\;;\;\vec{\Omega}) &=& \sigma\left(f(\vec{X}\;;\;\vec{\Omega})\right)\nonumber \\ \sigma(a) &=& \frac{1}{1+\exp{(-a)}}\label{new_sigmoid}\\ f(\vec{X}\;;\;\vec{\Omega}) &=& \vec{\Omega}^{\;T}\cdot\vec{X} \label{new_new_projection} \end{eqnarray} である。この式を $\vec{\Omega}$ で微分する。シグモイド関数なので計算は容易である。 \begin{equation} \frac{\partial L(\vec{\Omega})}{\partial \vec{\Omega}}=-\sum_{i=1}^{N}\;\vec{X}^{\;i} \left(c^{i}-s(1\;|\;\vec{X}^{\;i}\;;\;\vec{\Omega})\right) \label{gradient} \end{equation} これを0と置いたときの解が求める $\vec{\Omega}$ であるが、これ以上の解析計算は不可能である。そこで、勾配降下法を使って数値計算を行なう。手順は以下の通りである。
  1. $\vec{\Omega}$に適当な初期値を与える。
  2. 次式で $\vec{\Omega}$ を更新する。 \begin{equation} \vec{\Omega}\leftarrow \vec{\Omega} - \eta \frac{\partial L(\vec{\Omega})}{\partial \vec{\Omega}} \end{equation} ここで $\eta$ は学習率と呼ばれる正の量である。収束速度を調節するパラメータである。
  3. $L$ の変化量がしきい値以下となるまで上記を繰り返す。あるいは、エラー $E$ \begin{equation} E=\sum_{i=1}^{N}\;\left|c^{i}-s(1\;|\;\vec{X}^{\;i}\;;\;\vec{\Omega})\right| \end{equation} の変化量がしきい値以下となるまで繰り返しても良い。この量は理想的には0になって欲しい量である。

確率的勾配降下法(Stochastic Gradient Descent:SGD)


 式(\ref{gradient})を見て分る通り、通常の勾配降下法では $\vec{\Omega}$ の更新ごとに全観測値についての和を取る必要がある。大規模データの場合、これでは大変時間がかかる。そこで、$\vec{\Omega}$ の更新に使うデータをランダムに取り出すことを考える。この手法を確率的勾配降下法と呼ぶ。 手順は以下の通りである。
  1. データをシャッフルしたあと、複数のグループに分割する。たとえば、1000個のデータを10個のデータのグループに分割する。各グループはミニバッチ(minibatch)と呼ばれる。
  2. $\vec{\Omega}$に適当な初期値を与える。
  3. 次式で $\vec{\Omega}$ を更新する。
    • $\mbox{for}\;\;\;\;k = 1, \cdots,$ \begin{equation} \vec{\Omega}\leftarrow \vec{\Omega} - \eta \left\{ -\frac{1}{|\Lambda^{k}|} \sum_{i\;\in\;\Lambda^k}\;\vec{X}^{\;i} \left(c^{i}-s(1\;|\;\vec{X}^{\;i}\;;\;\vec{\Omega})\right) \right\} \label{grad} \end{equation}
    ここで $\Lambda^{k}$ は $k$ 番目のミニバッチを、$|\Lambda^{k}|$ はそこに含まれるデータの数を表す。
  4. 先の勾配法と同じように何らかの量がしきい値以下となるまで上記を繰り返す。

実装


 2次元平面に、(5,5)と(0,0)を中心にした2つの正規分布を使って1000個ずつ点を生成し、2分類問題を行なった。ミニバッチのサイズを10、学習率を0.1とした。Theanoを使って実装を行なった。
  • 45,46行目:行列とベクトルのシンボルを作成する。前者は座標を後者はラベルを格納する。
  • 49行目:パラメータ $\vec{\Omega}$ を表す共有変数である。
  • 55行目:$f$ を表すTheano Expression Graphである。
  • 58行目:$\sigma$ を表すTheano Expression Graphである。
  • 61行目:Negative Log Likelihood(NLL) を表すTheano Expression Graphである。
  • 64行目:ミニバッチ内でのNLLの平均値である。
  • 67行目:$\vec{\Omega}$についての微分を表すTheano Expression Graphである。
  • 70行目:学習率 $\eta$ を表す共有変数である。
  • 71行目:$\vec{\Omega}$ の更新を表現するTheano Functionである。
  • 76行目:$\eta$ の更新を表現するTheano Functionである。
  • 79行目:サンプルを作成する。
  • 84〜92行目:勾配降下法を実行する
  • 下図における青線が、識別関数 $f(\vec{X}\;;\;\vec{\Omega}) = \vec{\Omega}^{\;T}\cdot\vec{X}=0$ である。
    このときのエラー $E$(プログラム中のリストerrors)を下に示す。合計2000個のデータを200個のミニバッチに分割し、これを10回繰り返したので横軸の最大値は2000である。 振動しながら小さくなっていく様子が分かる。

    2014年11月3日月曜日

    Restricted Boltzmann Machine


    はじめに


     以前、Boltzmann Machineの基礎を解説し、その最後に隠れ変数の意味について述べた。今回はRestricted Boltzmann Machineについて解説する。

    Restricted Boltzmann Machine


     Restricted Boltzmann Machineとは、可視層(入力層)と隠れ層(出力層)の2層から構成されるBoltzmann Machineである。ユニット間の結合は層間にのみ存在し、同一層内には存在しない(下図参照)。これが名前の由来である。
    図の $\Gamma$ は可視ユニットの集合を、$\Lambda$ は隠れユニットの集合を表す。 エネルギー関数は次式で定義される。 \begin{equation} \Phi({\bf V},{\bf H}|{\boldsymbol \Theta}) = -\sum_{i\;\in\;\Gamma}\; \theta_{i}^V\;V_{i} -\sum_{j\;\in\;\Lambda}\;\theta_{j}^H\;H_{j} - \sum_{i\;\in\;\Gamma}\;\sum_{j\;\in\;\Lambda} \omega_{ij}\;V_{i}\;H_{j} \label{energy} \end{equation} ただし、${\boldsymbol \Theta}=({\boldsymbol \theta}^V, {\boldsymbol \theta}^H, {\boldsymbol \omega})$ とした。 可視層と隠れ層のバイアス項は区別される。 ${\bf V}$ と ${\bf H}$ はそれぞれ可視確率変数、隠れ確率変数を表す。

    学習方程式


     Restricted Boltzmann Machineの学習モデルは先の解説と同様にBoltzmann関数である。 \begin{equation} P_{B}({\bf V}, {\bf H}|{\boldsymbol \Theta}) = \frac{1}{ Z_{B}({\boldsymbol \Theta}) } \exp\left[-\Phi({\bf V},{\bf H}|{\boldsymbol \Theta})\right] \label{boltzmann-1} \end{equation} 式を扱い易くするため、統計物理学で使用される自由エネルギー $F({\boldsymbol V}|{\boldsymbol \Theta})$ \begin{equation} F({\boldsymbol V}|{\boldsymbol \Theta})= -\ln{ \left( \sum_{H_1=\pm1}\cdots\sum_{H_m\pm1}\; \exp \left[ -\Phi({\bf V},{\bf H}|{\boldsymbol \Theta}) \right] \right) } \label{free} \end{equation} を導入する。このとき正規化因子(分配関数)は次式で与えられる。 \begin{equation} Z_{B}({\boldsymbol \Theta})= \sum_{V_1=\pm1}\cdots\sum_{V_n=\pm1}\; \exp \left[ -F({\boldsymbol V}|{\boldsymbol \Theta}) \right] \end{equation} 式(\ref{energy})を式(\ref{free})に代入する。 \begin{eqnarray} F({\boldsymbol V}|{\boldsymbol \Theta}) &=& -\ln{\left( \sum_{H_1}\cdots\sum_{H_m}\; \exp \left[ \sum_{i\;\in\;\Gamma}\; \theta_{i}^V\;V_{i} +\sum_{j\;\in\;\Lambda}\;\theta_{j}^H\;H_{j} +\sum_{i\;\in\;\Gamma}\;\sum_{j\;\in\;\Lambda} \omega_{ij}\;V_{i}\;H_{j} \right] \right) } \nonumber \\ &=& -\ln{\left( \exp \left[ \sum_{i\;\in\;\Gamma}\; \theta_{i}^V\;V_{i} \right] \sum_{H_1=\pm 1}\cdots\sum_{H_m=\pm 1} \;\exp \left[ \sum_{j\;\in\;\Lambda}\;\theta_{j}^H\;H_{j} +\sum_{i\;\in\;\Gamma}\;\sum_{j\;\in\;\Lambda} \omega_{ij}\;V_{i}\;H_{j} \right] \right)} \nonumber \\ &=& -\ln{\left( \exp \left[ \sum_{i\;\in\;\Gamma}\; \theta_{i}^V\;V_{i} \right] \sum_{H_1=\pm 1} \;\exp \left[ \left\{\theta_{1}^H+\sum_{i\;\in;\Gamma}\;\omega_{i1}\;V_{i}\right\}H_1 \right] \cdots \sum_{H_m=\pm 1} \;\exp \left[ \left\{\theta_{m}^H+\sum_{i;\in\;\Gamma}\;\omega_{im}\;V_{i}\right\}H_m \right] \right)} \nonumber \\ &=& -\ln{\left( \exp \left[ \sum_{i\;\in\;\Gamma}\; \theta_{i}^V\;V_{i} \right] \prod_{j\;\in\;\Lambda}\;2\;\cosh{\left\{\theta_{j}^H+\sum_{i\;\in\;\Gamma}\;\omega_{ij}\;V_{i}\right\}} \right)} \nonumber \\ &=& -\sum_{i\;\in\;\Gamma}\;\theta_i^V\;V_i - \sum_{j\;\in\;\Lambda}\;\ln{ \left( 2\cosh{\left\{\theta_j^H+\sum_{i\;\in\;\Gamma }\omega_{ij}\;V_i\right\}} \right) } \label{free2} \end{eqnarray} $P_{B}({\bf V}, {\bf H}|{\boldsymbol \Theta})$を隠れ変数について周辺化したものは、自由エネルギー $F$ を使って 書くことができる。 \begin{eqnarray} P_{V}({\bf V}|{\boldsymbol \Theta}) &\equiv& \sum_{H_1}\cdots\sum_{H_m}\;P_{B}({\bf V}, {\bf H}|{\boldsymbol \Theta}) \nonumber\\ &=&\frac{1}{Z_B({\boldsymbol \Theta})}\; \exp{ \left[ -F\left({\boldsymbol V}|{\boldsymbol \Theta}\right) \right] } \label{marginalv} \end{eqnarray} この式を使って次式を最大化することを考える。 \begin{equation} L_{D}({\boldsymbol \Theta})=\sum_{\mu=1}^{N}\;\ln{P_{V}(\vec{v}^{\;\mu}|{\boldsymbol \Theta})} \label{logld} \end{equation} ここで、$\vec{v}^{\;\mu}$は観測値である。 議論を一般化するため、パラメータ群 ${\boldsymbol \Theta}$ を代表するパラメータ $\xi$ を考え、これによる偏微分を 考える。 \begin{equation} \frac{\partial L_D}{\partial \xi} = 0 \Leftrightarrow E_V\left(\frac{\partial F({\boldsymbol V}|{\boldsymbol \Theta})}{\partial \xi} \right) = \frac{1}{N}\;\sum_{\mu}\; \frac{\partial F(\vec{v}^{\;\mu}|{\boldsymbol \Theta})}{\partial \xi} \label{general} \end{equation} ここで、${\bf V}$ についての期待値 \begin{equation} E_V(\nu)=\sum_{V_1}\cdots \sum_{V_n}\; \nu\;P_{V}({\bf V}|{\boldsymbol \Theta}) \end{equation} を定義した。 式(\ref{general})の左辺は確率変数についての期待値、右辺は観測値ついての期待値である。 $\xi=\{\theta_i^V, \theta_j^H, \omega_{ij}\}$ として次式を得る。 \begin{eqnarray} \frac{\partial L_D}{\partial \theta_i^V} = 0 &\Leftrightarrow& E_V(V_i) = \frac{1}{N}\;\sum_{\mu}\;v_i^{\;\mu} \label{le-1}\\ \frac{\partial L_D}{\partial \theta_j^H} = 0 &\Leftrightarrow& E_V \left( \tanh{ \lambda_j^{H} } \right) = \frac{1}{N}\;\sum_{\mu}\; \tanh{\lambda_j^{H,\;\mu}} \label{le-2}\\ \frac{\partial L_D}{\partial \omega_{ij}} = 0 &\Leftrightarrow& E_V\left( V_i \tanh{ \lambda_j^{H} } \right) = \frac{1}{N}\;\sum_{\mu}\; v_i^{\;\mu} \tanh{\lambda_j^{H,\;\mu}} \label{le-3} \end{eqnarray} ここで \begin{eqnarray} \lambda_j^{H,\;\mu}&=&\theta_j^H+\sum_{k\;\in\;\Gamma}\omega_{kj}\;v_k^{\;\mu} \\ \lambda_j^{H}&=&\theta_j^H+\sum_{k\;\in\;\Gamma}\omega_{kj}\;V_k \end{eqnarray} とした。以下に $y=\tanh(x)$ のグラフを示す。
    式(\ref{le-1})(\ref{le-2})(\ref{le-3})が Restricted Boltzmann Machine の学習方程式である。3式とも、左辺は確率変数 ${\bf V}$ についての期待値であり、「計算量の爆発」問題を抱えている。近似的解法が必要である。

    RBMの性質


     式(\ref{marginalv})とベイスの公式を使うと、確率変数 ${\bf V}$ を固定したもとで隠れ変数 ${\bf H}$ が$\pm 1$になる確率を求めることができる。 \begin{eqnarray} P_{H|V}({\bf H}=\pm 1|{\bf V},\Theta)&=&\frac{P_B({\bf V},{\bf H}|\Theta)}{P_V({\bf V}|\Theta)} \nonumber \\ &=&\prod_{j\;\in\;\Lambda}\;\frac{1}{1+\exp{\left(\mp\;2\;\lambda_{j}^{H}\right)}} \label{prior-1} \end{eqnarray} また、$P_B({\bf V},{\bf H}|\Theta)$ に対し、可視変数で周辺化し同様な計算を繰り返すと、確率変数 ${\bf H}$を固定したもとで可視変数 ${\bf V}$ が$\pm 1$になる確率を求めることができる。 \begin{equation} P_{V|H}({\bf V}=\pm 1|{\bf H},\Theta)=\prod_{i\;\in\;\Gamma}\;\frac{1}{1+\exp{\left(\mp\;2\;\lambda_{i}^{V}\right)}} \label{prior-2} \end{equation} ここで \begin{eqnarray} \lambda_j^H&=&\theta_j^H+\sum_{k\;\in\;\Gamma }\omega_{kj}\;V_k \\ \lambda_i^V&=&\theta_i^V+\sum_{k\;\in\;\Lambda}\omega_{ik}\;H_k \end{eqnarray} とした。以下に $y=1/(1+\exp{(-x)})$ のグラフを示す。
    0から1の間を変化する関数、すなわち確率であることが確認できる。 式(\ref{prior-1})(\ref{prior-2})はいずれも、ユニットごとの確率の積となっている。これは、Restricted Boltzmann Machine に於いて、層内結合が存在しないためである。

     ところで、先の解説で、隠れ変数の導入はモデルの表現能力を高めると述べた。 式(\ref{marginalv})の形から、自由エネルギー $F$ は$P_B$における$\Phi$ に相当するものであることが分る。 $F$の第二項に対し、$\omega_{ij}$ を微小量としてテイラー展開を行なう。 \begin{eqnarray} \ln{2\cosh{\left(\theta_j^H+\sum_{k\;\in\;\Gamma }\omega_{kj}\;V_k\right)}}&=& \ln{2\cosh{\theta_j^H}}+\tanh{\theta_j^H} \cdot \sum_{k\;\in\;\Gamma}\omega_{kj}\;V_k \\ &+&\frac{1}{2} {\rm sech}^2 \theta_j^H \cdot \left( \sum_{k\;\in\;\Gamma}\omega_{kj}\;V_k \right)^2 \\ &-&\frac{1}{3} {\rm sech}^2 \theta_j^H \cdot \tanh{\theta_j^H} \cdot \left( \sum_{k\;\in\;\Gamma}\omega_{kj}\;V_k \right)^3\\ &+&{\it O}(\omega^4) \end{eqnarray} 最初に導入したエネルギー関数(\ref{energy})は可視ユニット間の相互作用を含まないが、"有効"エネルギー関数にはこの相互作用が現れている。これは、可視ユニット同士が隠れユニットを介して結合することを意味する。相互作用の出現によりモデルの表現能力が高まるのである。

    近似的解法(Contrastive Divergence)


     ここでは、確率変数についての期待値 $E_V(\nu)$ \begin{equation} E_V(\nu)=\sum_{V_1=\pm1}\cdots \sum_{V_n=\pm1}\; \nu(V_1,\cdots,V_n|{\boldsymbol \Theta})\;P_{V}(V_1,\cdots,V_n|{\boldsymbol \Theta}) \end{equation} を評価する近似法について述べる。右辺は $2^{n}$ 個の項の和であるが、これを観測値と同じ個数($N$)の項の和で近似する。 \begin{equation} E_V(\nu)\sim \frac{1}{N}\sum_{\mu=1}^{N}\; \nu(V_1^{\mu},\cdots,V_n^{\mu}|{\boldsymbol \Theta}) \label{app} \end{equation} 話しを進める前に、式(\ref{prior-1})(\ref{prior-2})から各ユニットの条件付き確率を求めておく。 \begin{eqnarray} P_{H|V} (H_j=\pm 1|{\bf V},\Theta) &=&\frac{1}{1+\exp{\left(\mp\;2\;\lambda_{j}^{H}\right)}},\;\; j\;\in\;\Lambda \label{unit1} \\ P_{V|H} (V_i=\pm 1|{\bf H},\Theta) &=&\frac{1}{1+\exp{\left(\mp\;2\;\lambda_{i}^{V}\right)}},\;\; i\;\in\;\Gamma \label{unit2} \end{eqnarray} まず最初に、${\bf V}^{\mu}=(V_1^{\mu},\cdots,V_n^{\mu})$ の初期値 ${\bf V}_0^{\;\mu}$ として観測値 $\vec{v}^{\;\mu}$ を採用する。 さらに、確率(\ref{unit1})を使って、${\bf H}^{\mu}=(H_1^{\mu},\cdots,H_m^{\mu})$ の初期値 ${\bf H}_0^{\;\mu}$ を計算する。 ${\bf H}^{\mu}_0$ と確率(\ref{unit2})を使って ${\bf V}^{\mu}_1$ を計算する。これを $T$ 回繰り返す。 \begin{equation} {\bf V}^{\mu}_0 \rightarrow {\bf H}^{\mu}_0 \rightarrow {\bf V}^{\mu}_1 \rightarrow {\bf H}^{\mu}_1 \cdots {\bf H}^{\mu}_{T-1} \rightarrow {\bf V}^{\mu}_T \nonumber \end{equation} ${\bf V}^{\mu}_T$ を式(\ref{app}) に代入する。 \begin{equation} E_V(\nu)\sim \frac{1}{N} \sum_{\mu=1}^{N}\; \nu({\bf V}^{\mu}_T|{\boldsymbol \Theta}) \end{equation} $T=1$ でも精度よく計算できることが知られている。

    参考文献

    1. ディープボルツマンマシン入門 ボルツマンマシン学習の基礎, 安田宗樹, 人工知能学会誌 28巻 3号, 2013年5月.
    2. Restricted Boltzmann Machines (RBM)
    3. コンピュータビジョン最先端ガイド6, 第4章 ディープラーニング